Go HTTP2 长流并发下的请求超时排查
最近在排查一个 Go 编写的大模型接口转发服务时,遇到了一个比较奇怪的问题:在同一个容器里直接用 wget 请求,能够正常返回;但是通过应用发起的小请求,却经常超时。
进一步观察发现,两个节点中,哪个节点正在承接火山的业务流量,哪个节点的小请求就容易失败;空闲节点则正常,其他上游也没有出现相同程度的问题。
最开始怀疑是网络或者连接池出了问题。最后通过抓包、长流并发实验和源码分析,发现这里需要区分两件事:连接还能接收新的 HTTP2 stream,不代表这条连接的传输性能足够;关闭 HTTP2,也不能解决模型本身推理时间过长的问题。
本文的源码分析基于 Go 1.25.1。文中的延迟是本次环境下的实测值,不代表所有 HTTP2 服务都会有相同表现。
问题排查
独立请求正常,不代表应用使用的连接正常
先看一下应用中的 HTTP 客户端初始化代码:
| |
应用会复用这个 Client。给小请求设置超时时,使用的是浅拷贝:
| |
这里复制了 Client,但 Transport 仍然是同一个对象,底层连接池并没有被复制。因此,小请求可能继续使用那条正在承载业务长流的 TCP 连接。
而每次独立启动 curl,或者重新创建 Transport 的测试程序,都有自己的连接状态。它成功了,并不能说明应用已经使用了很久的连接也正常。
为了尽量保持条件一致,我在容器里编译运行了一个使用相同 Transport 配置的 Go 程序,记录 DNS、TCP、TLS、取得连接、请求写入和收到响应等阶段。
单次请求中,HTTP/1.1 和 HTTP2 都能成功。进一步测试同一条 HTTP2 连接上顺序复用、20 并发混合流式和非流式请求,100 次也全部成功。
但这时发出的都是 hi、max_tokens:16 的短请求,基本几秒就结束了。真实业务中一直存在的长 stream,还没有被模拟出来。
查看应用实际使用的 TCP 连接
接下来查看容器网络中的连接,发现应用到火山的一条长连接存在明显的发送积压:
| |
其中,Send-Q 是待发送或尚未确认的数据队列;notsent 表示尚未发送的数据字节。cwnd 是 TCP 拥塞窗口,降到 1、重传退避持续增大,说明这条连接的发送进度已经受到影响。
对完整抓包按 TCP 序列区间做统计,得到下面的结果。这里只统计应用发往上游的数据,不包含纯 ACK:
| 抓包窗口 | 数据包数 | 重复发送的数据包数 | 发送字节,含重复 | 重复字节 | 重复字节占比 | 最长累计 ACK 停滞 |
|---|---|---|---|---|---|---|
| 第一份,约 162 秒 | 1155 | 305 | 1889913 | 444866 | 23.54% | 7.097 秒 |
| 第二份,约 86 秒 | 645 | 166 | 990878 | 233926 | 23.61% | 1.969 秒 |
最明显的一段是同一段 1448 字节的数据,第一次发送后又重发了 5 次,累计 ACK 超过 7 秒才继续推进。对端还通过 SACK 确认了后面的数据,但前面的字节缺口没有及时补齐。
需要注意,这里的 23.54% 是抓包窗口内重复发送字节的比例,不是线路丢包率。同一段数据可能多次重传,发送卸载也会影响抓包中看到的分段。
这些数据可以确认连接存在传输问题,但还不能判断丢失发生在哪一台网络设备,也不能仅凭中途开始、没有 TLS 握手的抓包确认这条既有连接的 HTTP 协议。
问题复现
长流和短探针同时运行
前面的短请求测试没有复现问题,于是改成下面的方式:
- 先启动 40 个背景流式请求,让模型持续输出较长的内容,并正常读取响应。
- 收到有效 SSE 数据后才把请求计为活跃流。正常结束的请求会补充下一条,维持背景负载。
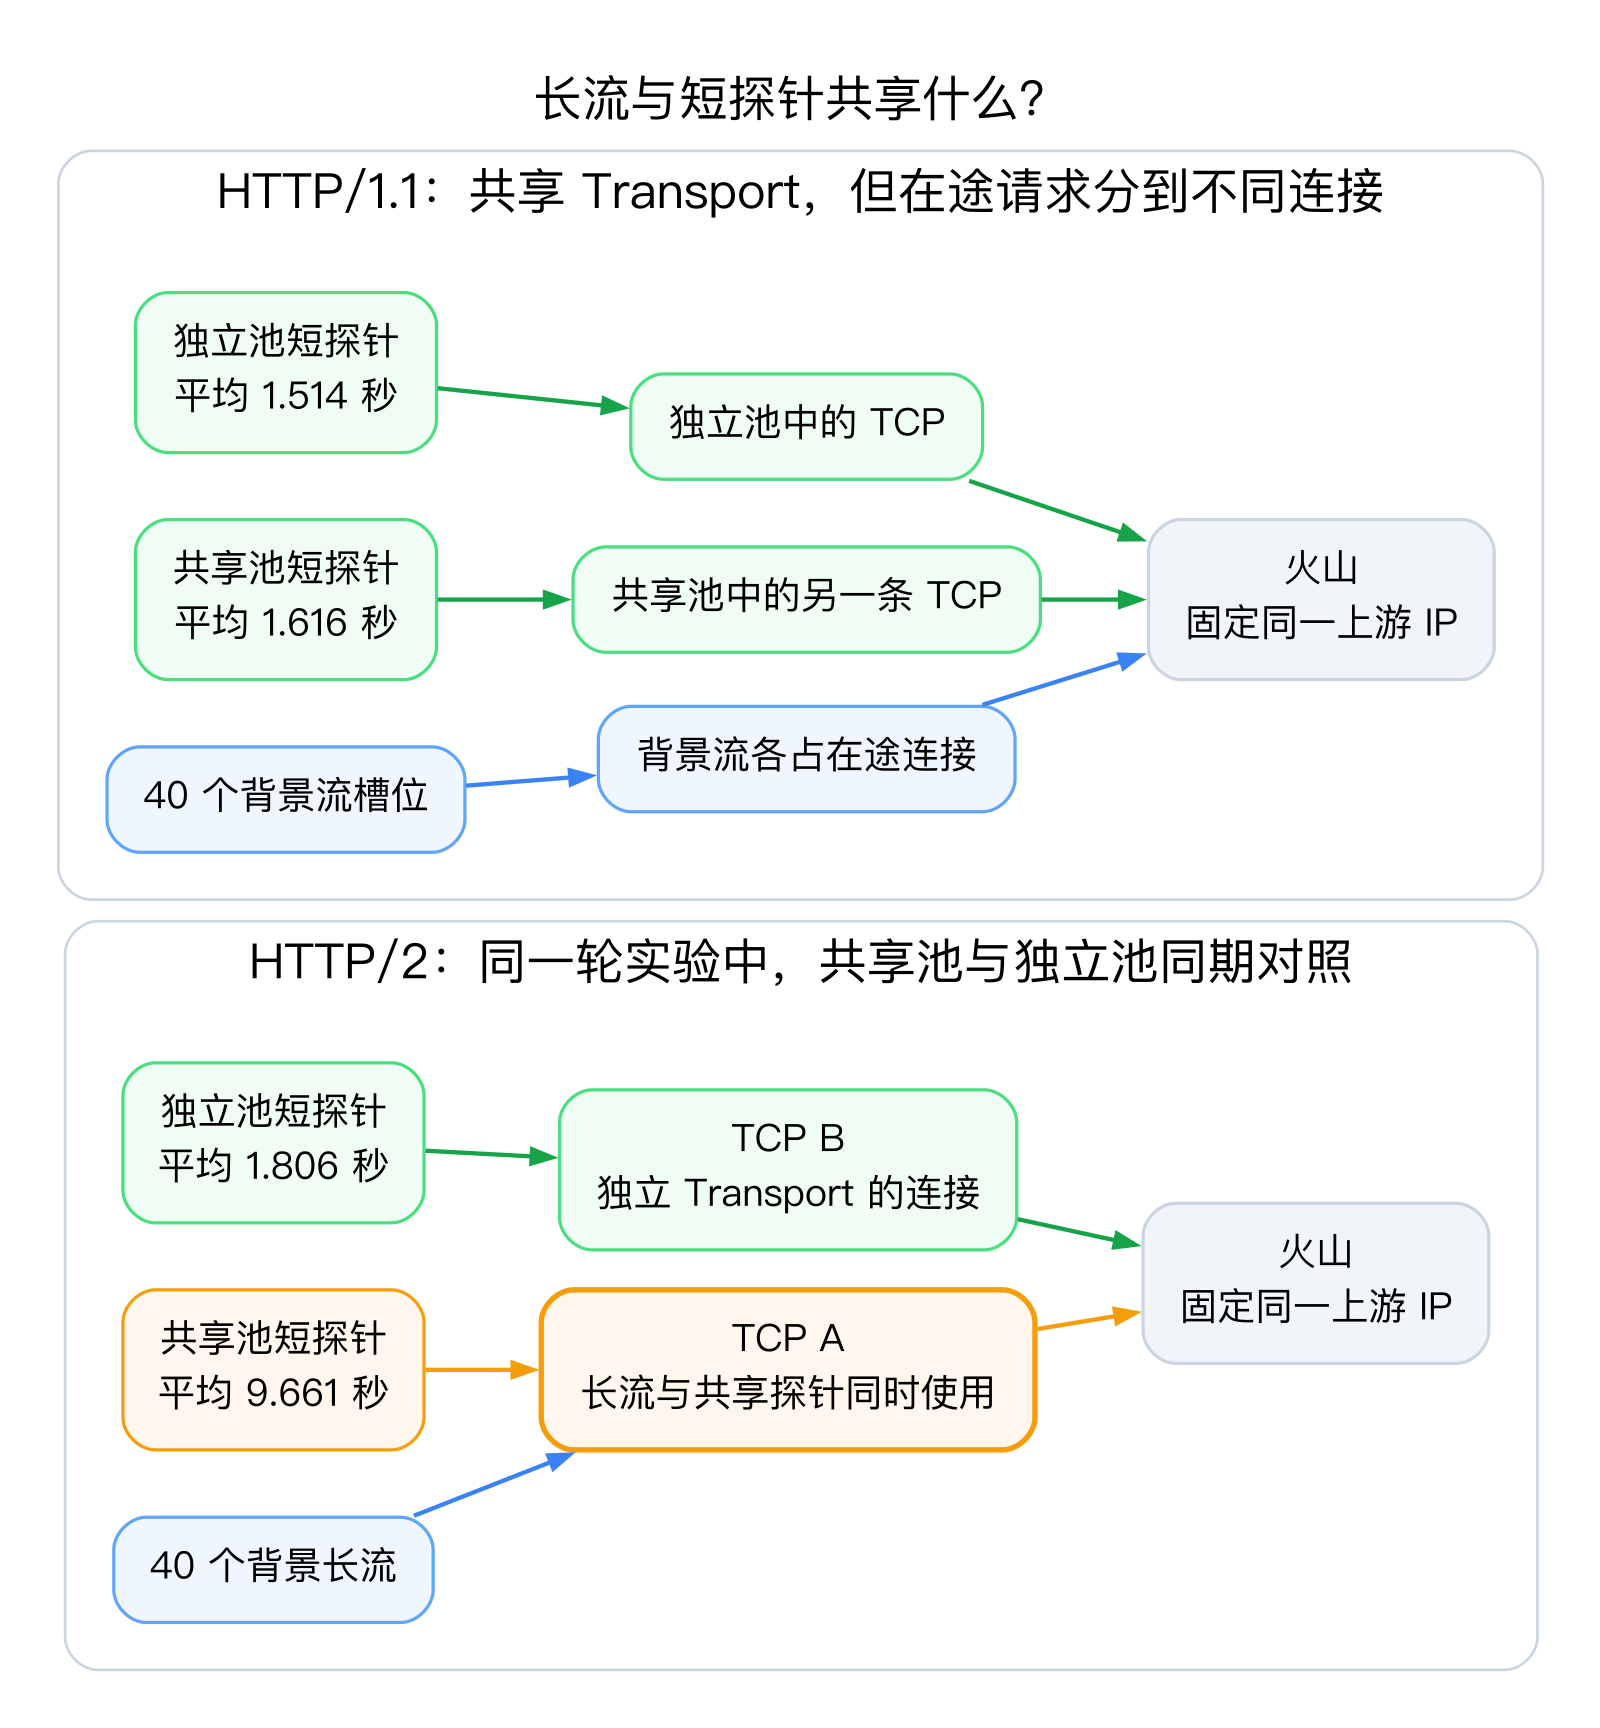
- 背景流运行时,再发两组非流式小探针:一组共享背景流的 Transport,另一组使用独立 Transport。
- 固定同一个上游 IP,同时保留原域名的 Host 和 TLS SNI,避免两组请求命中不同节点。
- 再将协议切换为 HTTP/1.1,保持相同请求体和参数做另一轮对照。
探针阶段持续 120 秒,每组最多一个在途请求,完成后间隔 1 秒再发,单个探针超时为 10 秒。因此,快的一组最终会完成更多请求。
连接关系如下,图片可以点击查看原图:
对照结果
| 指标 | HTTP2 共享池 | HTTP2 独立池 | HTTP/1.1 共享池 | HTTP/1.1 独立池 |
|---|---|---|---|---|
| 发起请求 | 12 | 43 | 46 | 48 |
| 成功 | 10 | 43 | 46 | 48 |
| 失败 | 1 | 0 | 0 | 0 |
| 实验结束主动取消 | 1 | 0 | 0 | 0 |
| 平均耗时 | 9.661 秒 | 1.806 秒 | 1.616 秒 | 1.514 秒 |
| P95 | 13.914 秒 | 2.809 秒 | 2.890 秒 | 2.048 秒 |
| 取得连接时,同连接有活跃长流 | 12/12 | 0/43 | 0/46 | 0/48 |
HTTP2 的共享池探针很快就取得了连接,但取得之后的耗时明显增加;唯一一次超时的请求,甚至没有观测到请求及 body 写入完成。
独立池同样使用 HTTP2,却没有这个程度的延迟。HTTP/1.1 即使共享 Transport,探针也不会与在途长流同时占用一条 TCP,耗时恢复到了独立池附近。
这轮确实存在长流:HTTP2 中有 40 条流实际持续了至少 30 秒;HTTP/1.1 中有 61 条。HTTP/1.1 预热时为 39/40,之后峰值达到 40,探针发起时仍有 34~40 条背景流。
两轮是顺序执行的,不是完全相同的时间。统计也排除了实验结束主动取消,但包含普通失败以及响应体关闭等收尾;因此,部分外层耗时超过配置的 10 秒,不能把它直接当作纯模型耗时。
到这里可以确认:**在这次环境和负载下,长流共享 HTTP2 连接会明显拖慢短请求,分开连接或改用 HTTP/1.1 能够缓解。**不过,具体涉及 TCP、HTTP2 流控还是上游调度,仍不能仅靠这组统计全部拆开。
Go 为什么没有新建连接
既然连接已经变慢了,为什么 Go 不再开几条 TCP?这就需要看一下 HTTP2 连接池的选择逻辑。
选择第一条能接收请求的连接
源码位于 net/http/h2_bundle.go。下面是 getClientConn 的关键部分,省略了日志和其他分支:
| |
可以发现,它会按同一个 host:port 遍历连接,找到第一条能够预留请求名额的连接就直接返回,没有比较哪条连接延迟更低、活动流更少。
继续看 ReserveNewRequest:
| |
判断和预留在同一把锁里完成,防止多个请求同时把最后一个名额当成可用。真正的容量判断在 idleStateLocked 中:
| |
已经使用的名额包括:
| |
streams:活动流。streamsReserved:已经预留、还没有正式创建的流名额。pendingResets:部分取消请求在等待确认对端仍响应时暂占的名额。
还要检查连接是否关闭、是否收到 GOAWAY、是否禁止复用等。但这些判断里没有 Send-Q、TCP 重传次数、拥塞窗口或最近请求耗时。
火山允许一条连接放多少个 stream
maxConcurrentStreams 来自服务端发来的 SETTINGS:
| |
为了确认实际值,我建立真实 TLS/HTTP2 连接,等待读取服务端 SETTINGS,并用 ClientConn.State() 交叉核对。2026 年 11 月 9 日,从工作机分别连接此前出现过的三个火山接入 IP,得到的 MAX_CONCURRENT_STREAMS 都是 100。
这不是只读取了 Go 的默认值,服务端实际帧里明确包含这个字段。但它仍是当次新连接的观测,不能代替先前生产连接的直接读取,服务端也可以后续更新。
现在再看前面的场景:
| |
即使这条 TCP 已经存在重传,只要状态和流名额仍允许,它仍可能被选中。“还有名额”并不代表“传输还很快”。
什么时候才会新建 TCP
默认情况下,已有连接都不能接收新流时,请求才会尝试从其他连接或新连接获取容量。标准库集成路径会交回外层 Transport.getConn,再由 queueForDial 检查总连接数限制并决定拨号。
这里的缓存未命中可能被转换为 ErrSkipAltProtocol,但不代表强制降级 HTTP/1.1,新连接仍可以协商为 HTTP2。
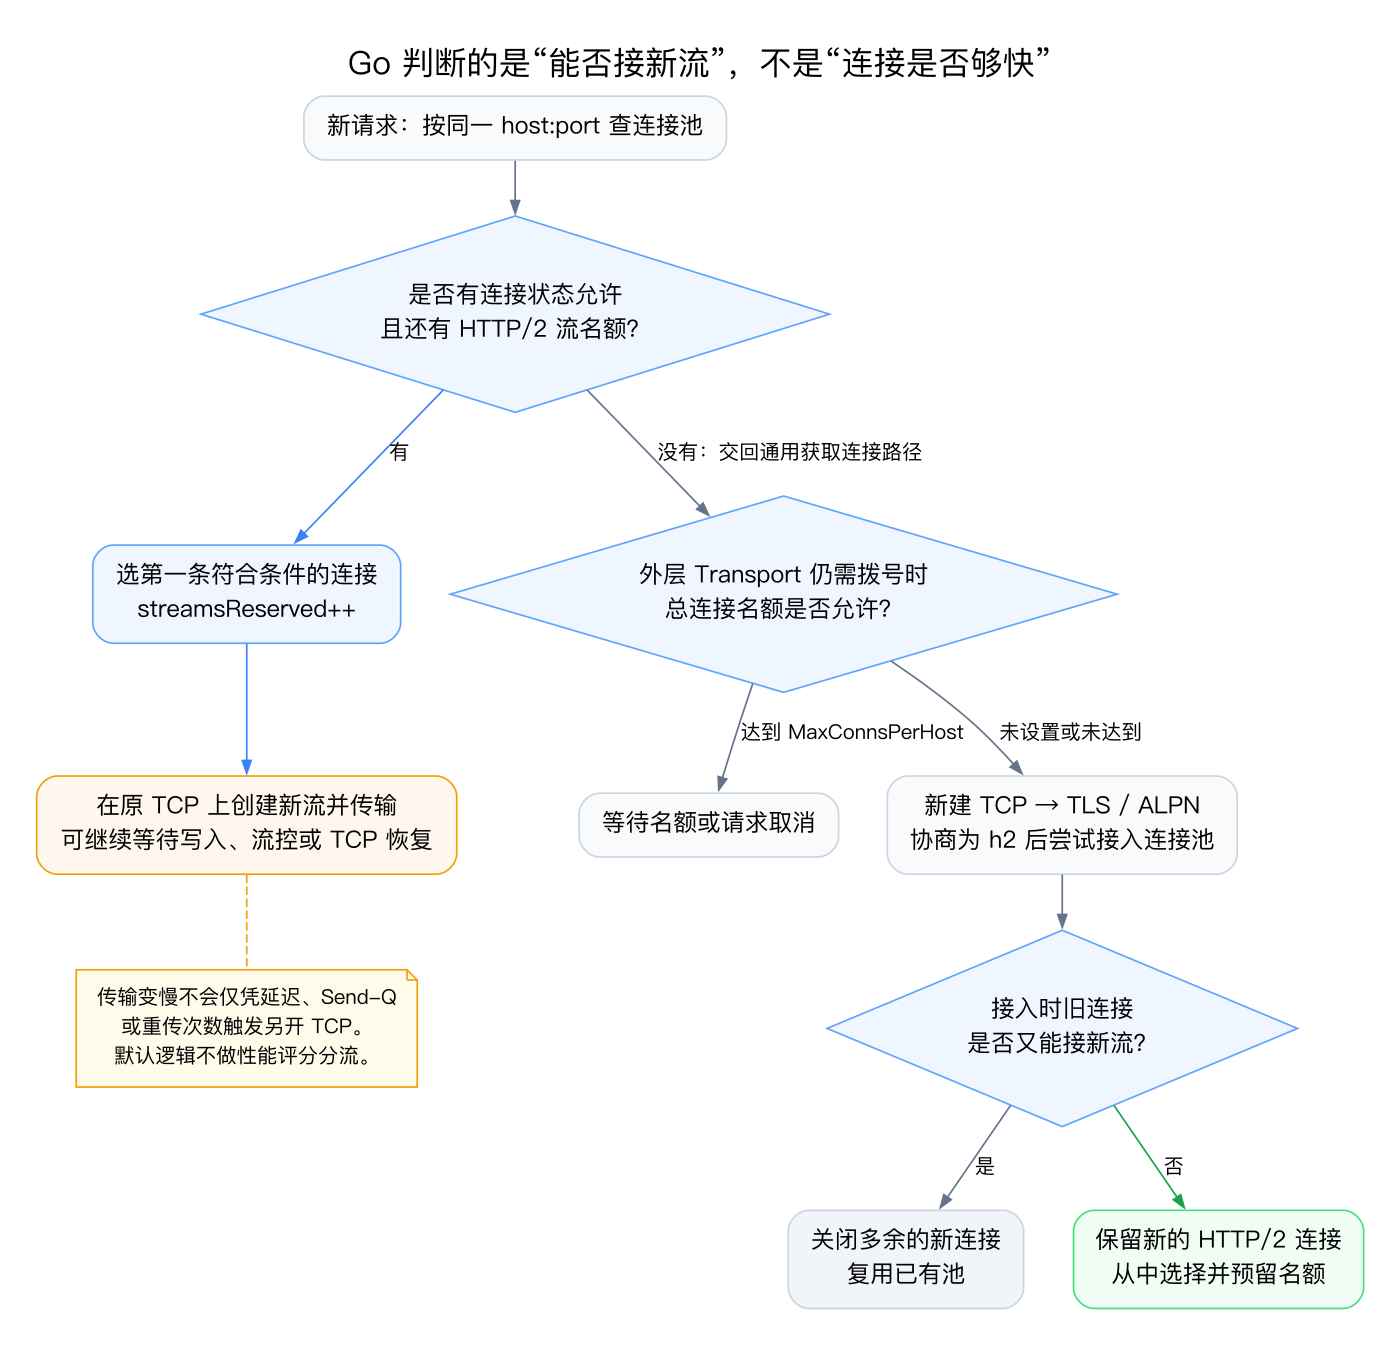
另外还有一个容易忽略的地方:即使并发请求已经拨出了多条 TCP/TLS 连接,接入 HTTP2 连接池时,Go 还会通过 addConnIfNeeded 再判断一次:
| |
如果已有连接此时又能接请求,新连接就不被接纳,调用方会关闭它。Go 并没有写死只能保留一两条连接,但默认会尽量复用已有容量。
这里内置 HTTP2 Transport 的 StrictMaxConcurrentStreams 默认是 false,允许在需要时增加连接。独立使用 golang.org/x/net/http2.Transport 时,可以配置这个布尔开关;如果设为 true,名额满时会倾向于等待,而不是仅因达到服务端流上限就扩连接。它不是一个可以设置“每条最多 10 个客户端请求”的数值参数。
MaxIdleConns 配置为什么没有解决问题
回到最开始的配置,这几个参数并不是一回事:
| 参数 | 实际作用 |
|---|---|
MaxIdleConns | 所有主机的空闲连接保留上限 |
MaxIdleConnsPerHost | 每个主机的空闲连接保留上限 |
MaxConnsPerHost | 每主机拨号中、活动和空闲连接的总数上限 |
将 MaxIdleConnsPerHost 设为 100,不会让 Go 自动建立 100 条 HTTP2 连接。MaxConnsPerHost 不设置也只是没有这个显式总数限制,不代表主动为慢连接分流。
至于 http.HTTP2Config.MaxConcurrentStreams,它限制的是对端发起的流。在 Go 1.25.1 客户端里,不能靠它把我们发出的请求改成“每条连接最多 10 个,满了再新建”。
处理方式
对受影响的上游使用 HTTP/1.1
这次实验中,HTTP/1.1 已经显著改善了短请求表现。如果服务同时连接多个上游,更适合按渠道控制,而不是直接改变所有上游的行为。
在本文使用的 Go 1.25.1 中,可以通过 http.Protocols 明确指定协议。在 Transport 第一次使用前设置:
| |
如果只是先做进程级对照,也可以在启动时设置:
| |
在另一个 shell 中 export 不会改变已运行进程;已经协商好的 HTTP2 连接也不会原地变成 HTTP/1.1。不要在并发使用中的 Transport 上直接修改配置字段。
这个方案会增加并发连接、文件描述符和 TLS 握手的开销。本次 HTTP/1.1 轮累计使用过 66 条 TCP,而 HTTP2 轮只有 2 条;这里是累计数,不是同时在线连接数。
保留 HTTP2,分散到多个连接池
另一种方式是创建多个独立 Transport,把请求分散出去。它可以降低单条连接承载的流量,但不等于精确限制每条连接的 stream 数量。
上游 new-api 的 PR #6143 也讨论过类似场景,后续 e99a9bd8 增加了渠道级协议选择和 HTTP2 连接分片。
本次没有继续验证分片数量与效果,因此不能把它与已经做过的 HTTP/1.1 实验混在一起。单独给健康探针开池也只会改善探针,业务请求之间的相互影响仍需要处理。
关闭 HTTP2 后,为什么还会超时
排查中还有一个后续现象:进程已经带着 GODEBUG=http2client=0 启动,部分 Pro 非流式请求仍然在 600 秒失败。
检查原始请求,发现使用的是最高推理强度,输出预算也很大:
| |
请求内容是一道数学证明题。保留原消息,只将输出上限改为 4096,独立 HTTP/1.1 重放约 57 秒返回,但结果是:
| |
这说明 4096 个输出 token 全部用于推理,而且碰到了上限,不能把 HTTP 200 当成原题已经完整回答。同期成功请求中也有输出 35524 token、耗时 570.436 秒的记录,因此还要考虑生成预算与非流式等待时限是否匹配。
但恢复原题和 131072 上限后,独立 wget 又在约 901 秒发生响应头读取错误,没有取得完成结果。这个时间是失败前等待时间,不是模型完成时间,也没有足够证据断言上游有固定 900 秒限制。
因此,长流共享连接造成的延迟,与任务本身过长、长时间无响应后的连接中断,需要分开验证。改用 HTTP/1.1 不会让模型计算更快;改为流式可以观察持续推理,但也不能直接当作非流式原请求的完成时间。
参考: